La stack
La stack LLM-First
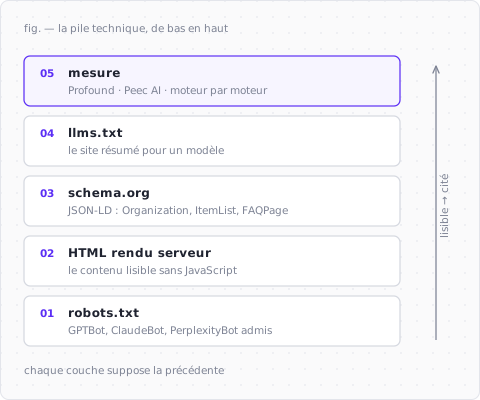
Lisible, compris, cité, mesuré : quatre couches, dans cet ordre.
LLM-First s'occupe de la partie du référencement sur les LLM que l'on voit le moins : ce qu'un crawler d'IA arrive à lire sur votre site, ce qu'un modèle comprend de vos pages, et ce que l'on peut en mesurer. Données structurées, rendu côté serveur, llms.txt, robots.txt des crawlers d'IA, suivi sur Profound et Peec AI.
Le point de départ est un constat de terrain : une marque peut être bien placée sur Google et absente des réponses de ChatGPT, de Claude ou des AI Overviews. La cause est souvent technique — un contenu injecté en JavaScript que GPTBot ne rend pas, un robots.txt qui bloque ClaudeBot sans que personne l'ait décidé, des pages sans balisage qui laissent le modèle deviner qui vous êtes.
Notre conviction : avant d'écrire pour les modèles, il faut être lisible par eux. Un contenu excellent servi en JavaScript, derrière un pare-feu qui filtre les robots ou sans aucune donnée structurée, n'entre jamais dans la réponse. C'est cette couche-là que nous traitons en premier, puis nous mesurons ce qu'elle change.
Vision
Ce qui guide chaque mission
Le code avant la copie
La plupart des chantiers de référencement LLM commencent par le contenu. Nous commençons par le HTML servi, les en-têtes, le robots.txt et le JSON-LD, parce qu'un modèle ne cite que ce qu'il a pu récupérer et interpréter. Les corrections arrivent sous forme de diff, pas de recommandations générales.
Une page citable est une page structurée
Une réponse de ChatGPT ou de Perplexity reprend des faits courts, datés, attribuables : un tableau, une définition, une question suivie de sa réponse. Nous structurons vos pages pour qu'elles fournissent ces blocs, et nous les balisons (Organization, Product, FAQPage, ItemList) pour qu'une machine sache ce qu'elle lit.
Ce qui n’est pas mesuré n’est pas livré
Chaque correction est rattachée à un panel de prompts suivi sur Profound ou Peec AI, moteur par moteur. On sait ce qui a bougé, sur quel moteur, et à partir de quand. Sans état zéro, il n'y a pas de résultat à montrer.
Les couches
Chaque couche suppose la précédente
| Couche | Ce que nous livrons |
|---|---|
| robots.txt Accès des crawlers d’IA | Chaque robot nommé un par un, selon son usage (entraînement, recherche, consultation en direct), et vérification dans les journaux du serveur. |
| HTML Rendu lisible sans JavaScript | Rendu côté serveur ou pré-rendu des pages qui comptent, contenu essentiel dans le HTML initial, titres et tableaux en balises réelles. |
| JSON-LD Données structurées | Organization, Product ou Service, FAQPage sur une FAQ visible, ItemList sur les listes ordonnées, BreadcrumbList partout. |
| llms.txt Synthèse pour les modèles | Un llms.txt généré depuis vos données, qui ne peut pas diverger des pages qu'il résume. Un complément, jamais un substitut au HTML. |
| réponse Pages citables | Des blocs que les moteurs reprennent : définition en tête, tableau comparatif, questions-réponses, chiffres datés et sourcés. |
Façon de travailler
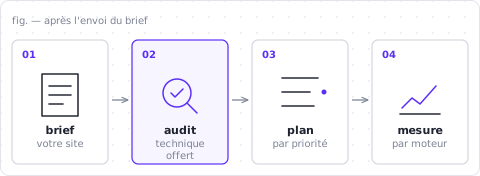
Audit, plan, mesure
Lisible avant d’être cité
Un modèle ne recommande pas ce qu'il n'a pas pu lire. Tout commence par l'audit technique : rendu, balisage schema.org, llms.txt, accès des crawlers d'IA. L'audit est offert.
Mesuré, moteur par moteur
ChatGPT, Claude, Gemini, Perplexity, AI Overviews et Copilot ne citent pas les mêmes sources. Le suivi se fait sur Profound ou Peec AI, sur un panel de prompts défini avec vous, pas à l'intuition.
Une méthode orientée résultat
LLM-First travaille de façon tactique, orientée résultat, avec des contrats peu engageants. L'équipe produit et l'équipe marketing ont le même interlocuteur.
Le point de départ est toujours le même : l'audit technique. Pour voir comment le marché travaille, le leaderboard des agences LLM les classe une par une.
Audit offert
Votre site est-il lisible par les IA ? LLM-First vous répond sous 24 h.
Audit technique offert : rendu, données structurées, llms.txt, crawlers d'IA.