Docs
La checklist technique du référencement LLM, vue par une agence : ChatGPT, Claude, Perplexity
5 octobre 2026 · Par LLM-First
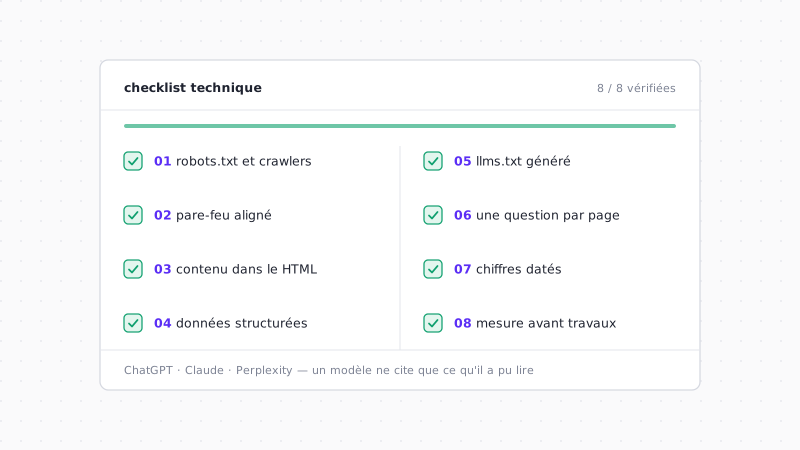
Un modèle de langage ne recommande pas une marque qu’il n’a pas pu lire. C’est l’évidence la plus souvent oubliée du référencement LLM : avant de parler de contenu, de mentions ou de stratégie, il faut savoir si les robots de ChatGPT, de Claude ou de Perplexity accèdent réellement à vos pages, et ce qu’ils y trouvent. Dans le classement LLM-First, 33 agences sur 50 déclarent un volet technique. Voici ce que ce volet devrait couvrir, dans l’ordre où nous le vérifions.
1. Le robots.txt nomme-t-il les crawlers d’IA ?
Chaque éditeur de modèle déclare ses robots, et la plupart en ont plusieurs,
avec des rôles différents. Chez OpenAI, GPTBot collecte pour l’entraînement,
OAI-SearchBot alimente la recherche de ChatGPT et ChatGPT-User ouvre les
pages pendant une conversation. Anthropic déclare ClaudeBot, Perplexity
PerplexityBot et Perplexity-User, Google le jeton Google-Extended, Apple
Applebot-Extended.
La question n’est pas « faut-il tout ouvrir ? » mais « qu’a-t-on décidé ? ». Beaucoup de sites bloquent un robot de recherche par accident, en recopiant une règle pensée pour l’entraînement. Si vous voulez apparaître dans les réponses, les robots de recherche et ceux déclenchés par l’utilisateur doivent passer. Un robots.txt qui nomme chaque robot, un par un, rend la décision lisible — pour eux comme pour votre équipe.
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
Un détail qui coûte cher : écrivez ce fichier en ASCII pur. Il est lu par des dizaines de robots dont la tolérance à l’encodage varie.
2. Le pare-feu laisse-t-il passer ce que le robots.txt autorise ?
Le robots.txt exprime une intention ; le CDN l’applique ou non. Les protections
anti-robots activées par défaut chez certains hébergeurs bloquent des crawlers
d’IA que le robots.txt autorise. Le seul moyen de le savoir est de regarder les
journaux : si aucun GPTBot ni ClaudeBot n’apparaît en un mois, le site est
probablement fermé, pas ignoré. Cloudflare, par exemple, affiche ces passages
robot par robot.
3. Le contenu est-il dans le HTML ?
Googlebot exécute le JavaScript. Tous les crawlers d’IA ne le font pas, ou pas systématiquement. Une page dont le texte, les prix ou les avis sont injectés côté client peut apparaître vide à un robot qui ne lit que le HTML initial.
Le test est simple : affichez le code source de la page (pas l’inspecteur) et cherchez-y la phrase qui décrit votre offre. Si elle n’y est pas, un rendu côté serveur ou une génération statique s’impose sur les pages qui comptent : accueil, pages produit ou service, tarifs, comparatifs.
4. Les données structurées disent-elles ce qu’est la page ?
Le balisage schema.org, en JSON-LD, dit à une machine ce qu’elle regarde : une
organisation (Organization), un produit (Product), une liste ordonnée
(ItemList), un fil d’Ariane (BreadcrumbList), une foire aux questions
(FAQPage). Il ne fait pas citer une page à lui seul, mais il retire une part
de devinette.
Deux règles évitent les faux pas. Le balisage doit décrire ce qui est visible :
une FAQPage dont les questions n’apparaissent pas dans la page est une
violation des consignes de Google, pas un raccourci. Et il doit rester
cohérent : un nom d’entreprise, une adresse et un logo identiques partout.
5. Un fichier llms.txt, généré plutôt qu’écrit
Le fichier llms.txt est une proposition de format : un résumé en Markdown,
placé à la racine du site, qui dit à un modèle ce que contient le site et où
trouver l’essentiel. Aucun grand moteur ne garantit qu’il le lit, et il ne
remplace ni un HTML lisible ni des données structurées.
Il coûte pourtant peu à produire, à une condition : qu’il soit généré depuis
les mêmes données que le site. Un llms.txt écrit à la main diverge du site à
la première mise à jour. Celui de ce classement, à l’adresse /llms.txt, est
reconstruit à chaque publication : il ne peut pas contredire les pages.
6. Les pages répondent-elles à une question précise ?
Un modèle extrait des passages. Une page qui répond en tête à la question qu’elle traite — définition, prix, différence entre deux options — offre un passage facile à reprendre. Les blocs de questions-réponses, les tableaux de comparaison et les listes numérotées sont surreprésentés dans ce que citent les moteurs génératifs, parce qu’ils ont déjà la forme de la réponse.
À l’inverse, une page d’accueil qui enchaîne slogans et visuels ne donne rien à citer. Ce n’est pas un problème de style, c’est un problème de matière.
7. Les chiffres sont-ils datés et à jour ?
Les modèles reprennent volontiers un chiffre précis, et l’attribuent. Un chiffre faux est donc repris faux, sous votre nom. Datez ce que vous publiez — « mis à jour le » sur les pages de référence — et évitez les nombres écrits en dur qui vieillissent sans prévenir. Sur ce site, les chiffres cités dans les textes sont recomptés à chaque publication à partir des données du classement.
8. La mesure existe-t-elle avant les travaux ?
Une checklist technique ne prouve rien sans mesure avant et après. Relevez, sur un panel fixe de prompts, si votre marque est citée par ChatGPT, Claude, Gemini, Perplexity et les AI Overviews, à quelle place, et avec quelles sources. Des outils comme Profound ou Peec AI automatisent ce relevé ; sur le classement, 21 agences sur 50 nomment au moins un outil de mesure dans leur offre publique.
Les effets ne sont pas immédiats : il faut que les robots repassent, que les index se mettent à jour, puis que les réponses changent. Comptez plusieurs semaines avant de conclure, et comparez toujours le même panel.
Ce que cette checklist ne couvre pas
Le technique lève les obstacles ; il ne crée pas la recommandation. Un site parfaitement lisible reste absent des réponses si personne d’autre ne parle de lui. Les modèles s’appuient sur des sources externes — comparatifs, médias, annuaires, forums — et c’est là que se joue la suite. C’est pourquoi le barème de ce classement ne s’arrête pas au socle technique : il pèse aussi les moteurs suivis, les outils de mesure nommés et la visibilité mesurée dans ChatGPT.
Pour aller plus loin, la page services : technique classe les agences qui déclarent ce volet, et la méthodologie détaille le barème. Si vous voulez que nous passions votre site à cette checklist, l’audit technique est offert.
Audit offert
Votre site est-il lisible par les IA ? LLM-First vous répond sous 24 h.
Audit technique offert : rendu, données structurées, llms.txt, crawlers d'IA.